什么是 Transformer?
Transformer 是一种神经网络架构,显著改变了人工智能处理信息的方式。它最早在 2017 年的论文 《Attention is All You Need》 中提出,随后广泛用于深度学习,包括 OpenAI 的 GPT、Meta 的 Llama 和 Google 的 Gemini 等文本生成模型。它也用于音频生成、图像识别、蛋白质结构预测,甚至游戏决策等领域。
文本生成 Transformer 的基本任务是预测下一个词元(token):给定用户输入,接下来最可能出现的词元,也就是单词或单词的一部分是什么?它的核心机制是自注意力,可以在处理序列时建立不同位置之间的联系,捕捉远距离依赖。
当前视图使用 UER 中文 GPT-2。它是预训练的中文续写模型,包含 12 个 Transformer 层,每层有 12 个注意力头,嵌入维度为 768。模型沿用 GPT-2 的结构,中文词表包含 21,128 个词元。为减小浏览器下载体积,线性层权重采用 INT8 量化;界面展示的注意力矩阵和预测结果由这个部署版本计算。它用于续写文字,并非对话助手。
Transformer 的整体结构
文本生成 Transformer 可以分为三个主要部分:
- 嵌入(Embedding):把输入文字拆成词元,再转换成用于表达含义的数值向量。词元可以是单词,也可以是单词的一部分。
- Transformer 层(Block)是处理输入的基本单元,每层包括:
- 注意力机制(Attention):让不同词元交换信息,捕捉上下文以及词语之间的关系。
- 多层感知机(MLP):对每个词元独立进行前馈计算。注意力负责词元之间的信息交流,MLP 则进一步加工每个词元的表示。
- 输出概率(Output Probabilities):最后的线性层和 Softmax 将处理后的向量转成概率,用来预测下一个词元。
嵌入(Embedding)
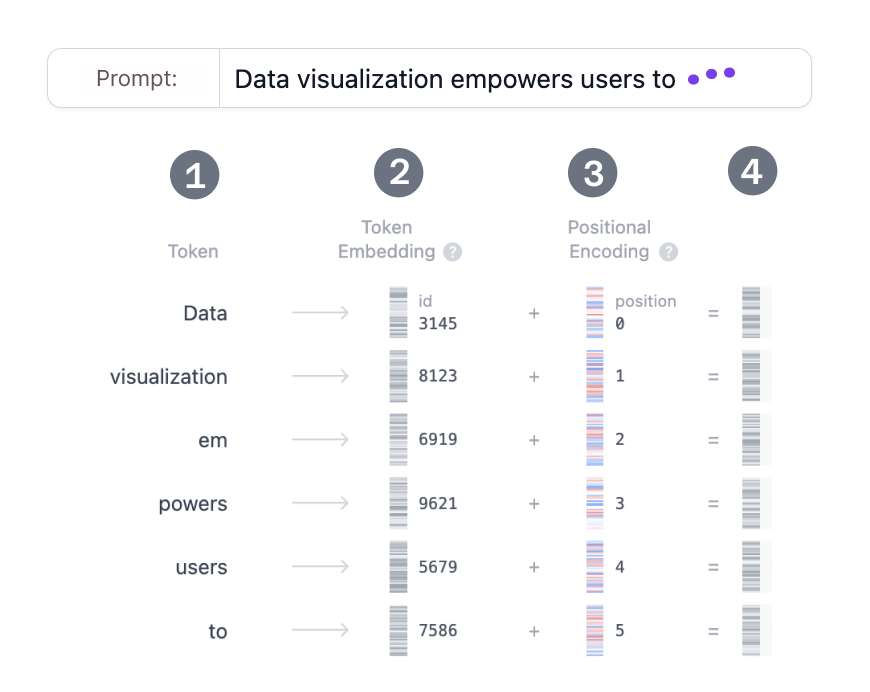
假设输入提示词 “Data visualization empowers users to”,希望模型接着生成文字。模型需要先将文字转换为能够处理的数字表示,这就是嵌入的作用。过程包含四步:1)分词;2)取得词元嵌入;3)加入位置信息;4)将词元嵌入与位置编码相加,得到最终的输入向量。
第 1 步:分词(Tokenization)
中文模型采用 WordPiece 分词。例如,今天天气会被拆成四个汉字词元。某些词语、符号和拉丁字母片段使用其他词元,## 表示词内的接续片段。词表共包含 21,128 个词元。下方示意图展示的是原版英文 GPT-2 的分词;中文分词可以在上方交互视图中观察。
第 2 步:词元嵌入(Token Embedding)
中文模型用 768 维向量表示每个词元。嵌入矩阵的形状为 (21,128, 768),约包含 1620 万个参数。这些训练得到的向量会经过下文介绍的相同 Transformer 运算。
第 3 步:位置编码(Positional Encoding)
除了词元本身的含义,模型还需要知道它在序列中的位置。不同模型使用不同的位置编码方法。GPT-2 的位置编码矩阵是在训练过程中学习得到的。
第 4 步:最终嵌入
将词元嵌入与位置编码相加,就得到最终的输入向量。这个向量同时包含词元的语义信息和它在序列中的位置信息。
Transformer 层(Block)
Transformer 的主要计算发生在一个个层中,每层包含多头自注意力和多层感知机。多个层依次堆叠,词元的表示随计算逐层变化,逐步融合更丰富的上下文信息。这里使用的 GPT-2(small)共有 12 层。
多头自注意力(Multi-Head Self-Attention)
自注意力建立词元之间的联系,让每个词元的表示受到其他词元的影响。多个注意力头可以从不同角度捕捉关系,例如局部语法联系或更广的语义上下文。下面按计算顺序逐步展开。
第 1 步:查询、键和值矩阵
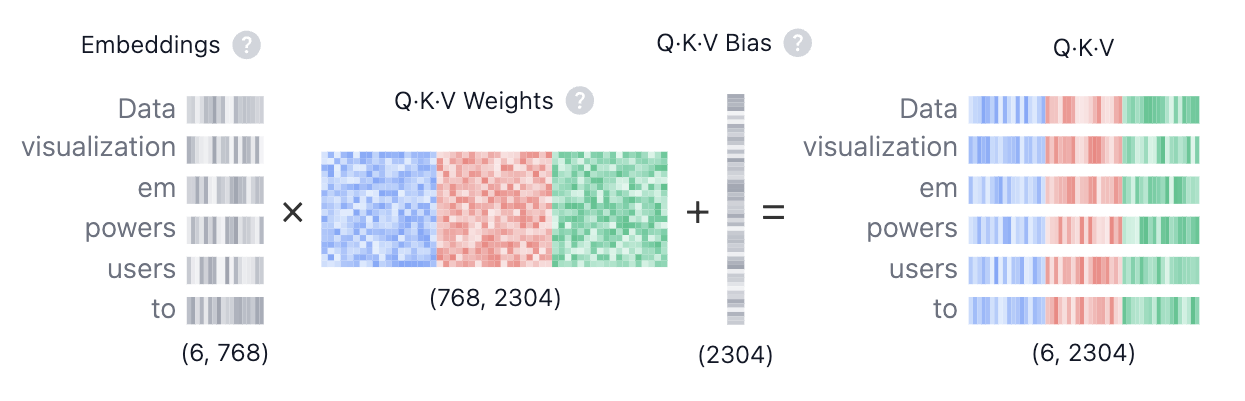
每个词元的嵌入被转换成三个向量:查询(Query,Q)、键(Key,K)和值(Value,V)。转换通过与训练得到的权重矩阵相乘并加上偏置完成。可以用搜索引擎来类比它们的分工:
- 查询(Query,Q)像搜索框中输入的搜索词,表达这个词元想要“寻找什么信息”。
- 键(Key,K)像搜索结果中各网页的标题,用来判断哪些内容与查询相关。
- 值(Value,V)像网页的实际内容。查询与键匹配后,模型按相关程度汇总这些值。
通过 Q、K、V,模型可以计算注意力分数,并据此决定在预测时应从各词元获取多少信息。
第 2 步:拆分为多个注意力头
查询、键和值向量被拆分给多个注意力头,GPT-2(small)中有 12 个头。每个头独立处理向量的一部分,学习不同的语法或语义关系。这种并行计算能丰富模型的表示能力。
第 3 步:带掩码的自注意力
每个头都会计算带掩码的自注意力,让模型关注相关的输入内容,同时无法访问当前词元之后的未来词元。
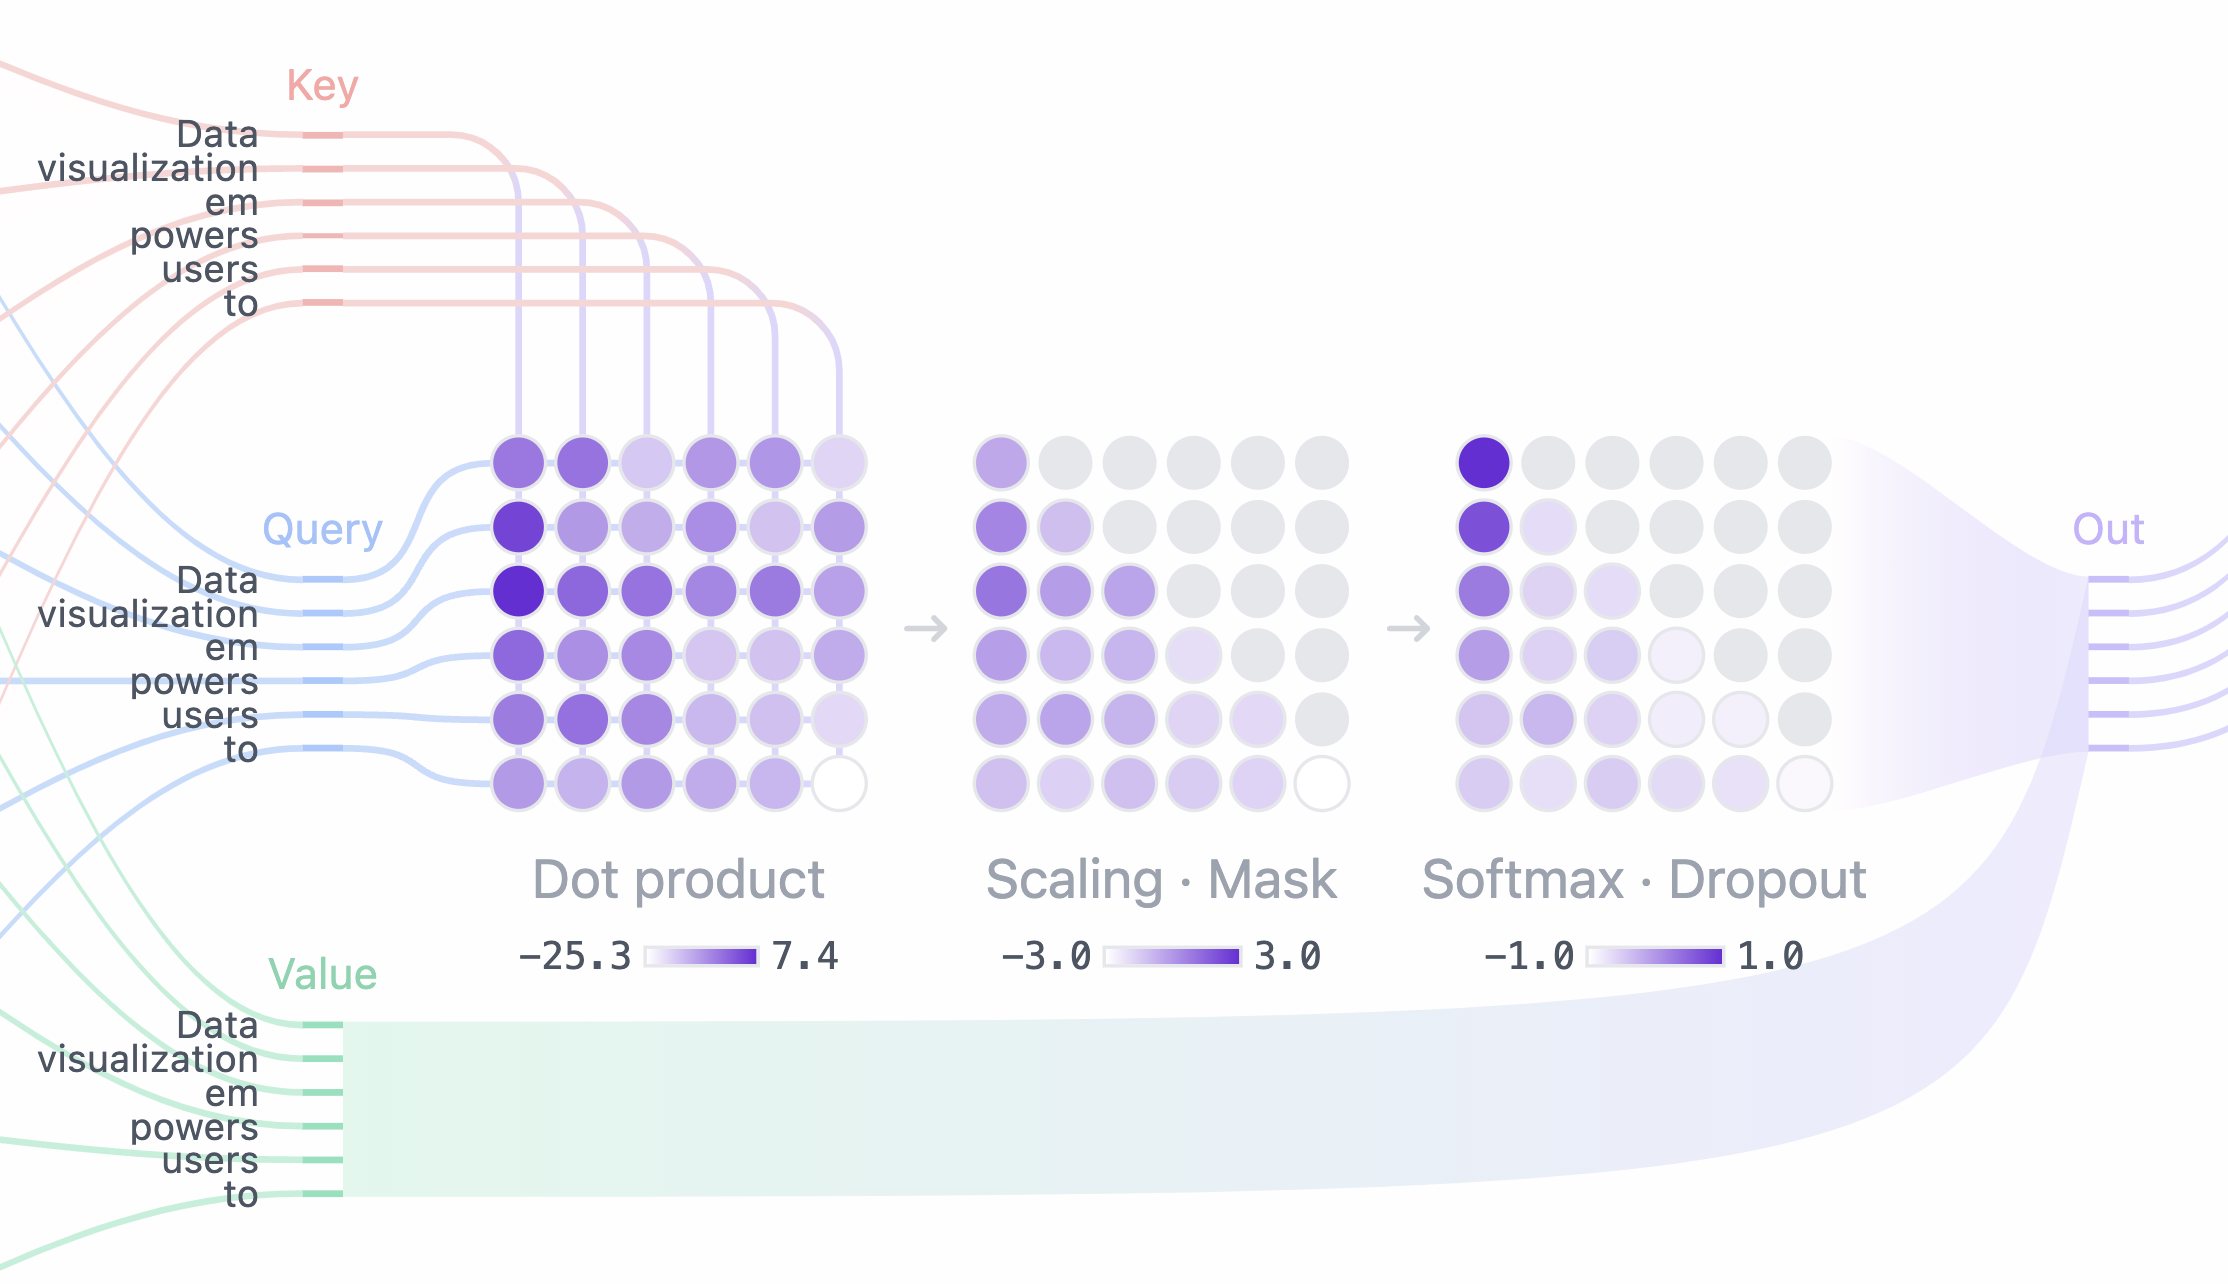
- 点积(Dot Product):将查询矩阵与转置后的键矩阵相乘,得到注意力分数组成的方阵,描述输入词元之间的相关程度。
- 缩放与掩码(Scaling · Mask):先缩放注意力分数,再将矩阵中对应未来词元的位置设为负无穷。这样模型预测下一个词元时就无法“偷看”未来。
- Softmax 与 Dropout:Softmax 将分数转换为注意力权重,每行之和为 1,表示对当前及此前词元的关注程度。训练时还可以应用 Dropout 进行正则化;推理时将其关闭。
第 4 步:输出与拼接
将归一化后的注意力权重与值(Value)矩阵相乘,得到每个头的注意力输出。GPT-2 的 12 个头各自捕捉不同的关系,它们的输出会被拼接起来,再经过一次线性投影。
多层感知机(MLP)
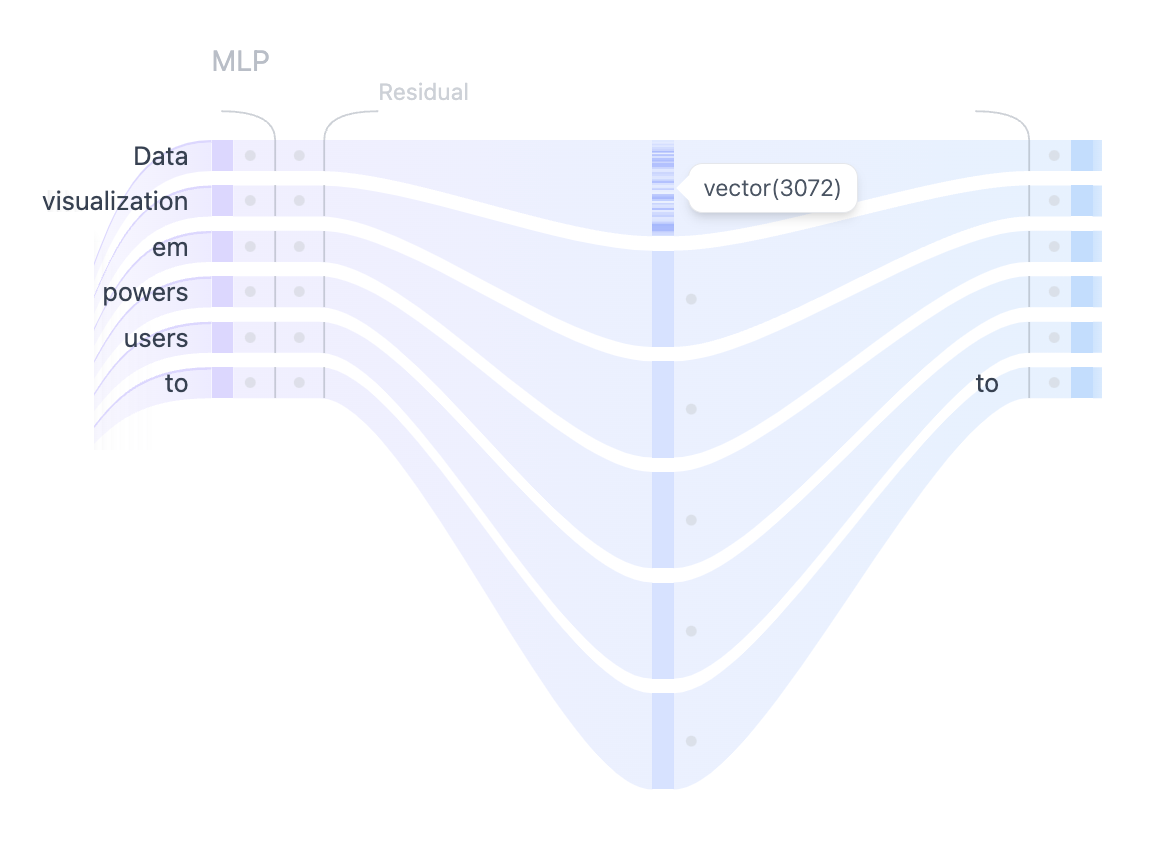
多头自注意力融合了上下文后,词元表示还会经过多层感知机(MLP)。MLP 包含两次线性变换,中间使用 GELU 激活函数引入非线性。
第一次线性变换将维度从 768 扩展到 3072,扩大为原来的四倍,让模型在更高维空间中学习更丰富、更复杂的模式。
第二次线性变换把维度压回 768,在保留有用的非线性变换结果的同时,恢复原来的向量大小。
自注意力会在不同词元之间汇总信息;MLP 则独立处理每个词元,将其表示从一个空间映射到另一个空间。
输出概率
最后的线性层将最后一个词元的表示投影到 21,128 维空间。每个值都是一个词表候选词元的 logit。温度和采样设置决定如何根据这些分数预测下一个词元。
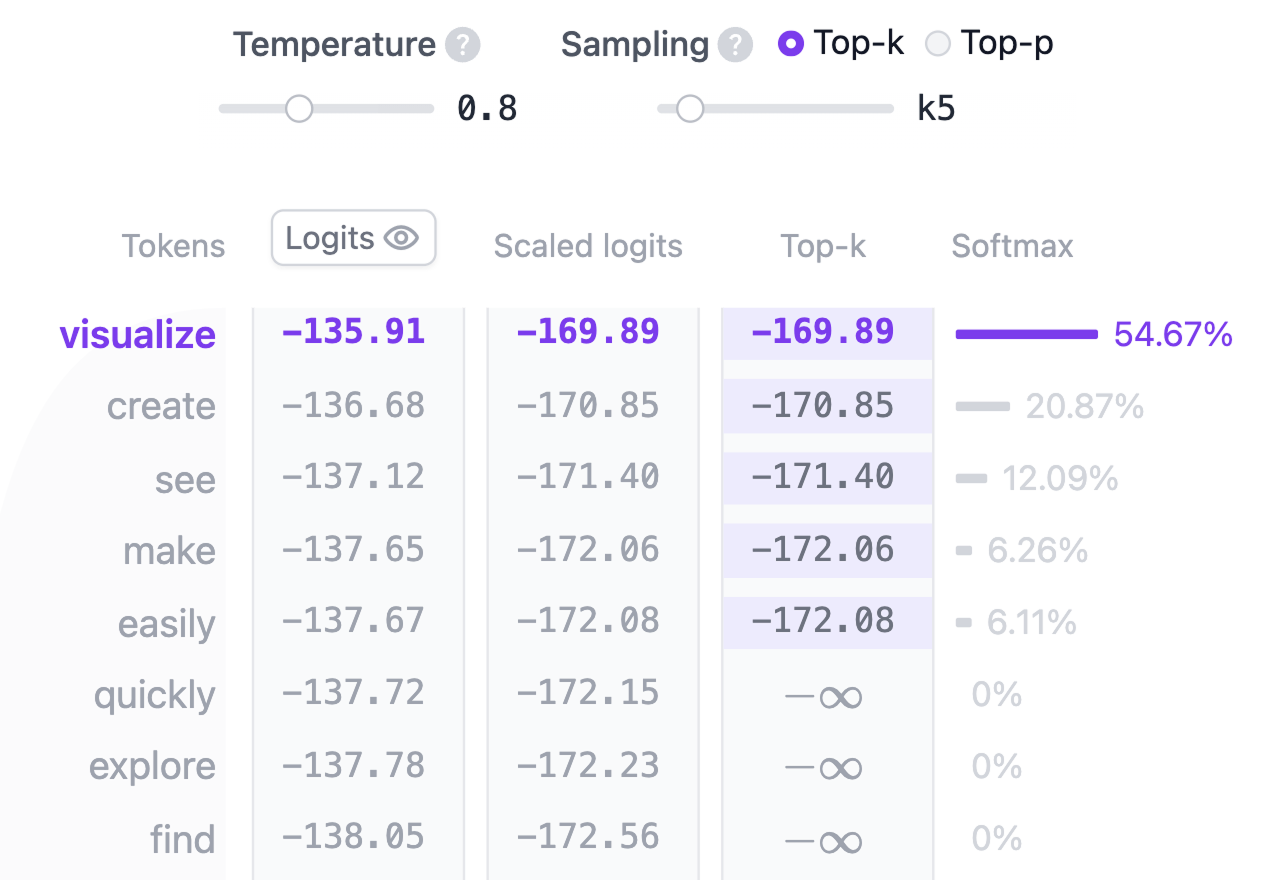
最后一步是从分布中采样。temperature(温度)会影响这个过程:在转换为概率之前,将模型输出的 logits 除以 temperature:
temperature = 1:除以 1 不改变分数,Softmax 的结果保持不变。temperature < 1:放大分数差距,使概率分布更集中,输出更容易预测。temperature > 1:缩小分数差距,使概率分布更平缓,生成文本的随机性更高,有时也被称为更有“创造性”。
还可以用 top-k 和 top-p 进一步限定采样范围:
top-k sampling:只保留概率最高的 k 个候选词元,过滤其余候选。top-p sampling:按概率从高到低,保留累计概率达到阈值 p 的最小候选集合。
调节 temperature、top-k 和 top-p,可以在输出的确定性与多样性之间取得不同的平衡。
辅助结构与机制
除了注意力和 MLP,Transformer 还有一些帮助模型稳定工作和训练的机制。层归一化有助于稳定数值分布;Dropout 通过随机失活减少过拟合;残差连接让信息和梯度更容易穿过深层网络。
层归一化(Layer Normalization)
层归一化对每个词元的特征进行归一化,再使用学到的缩放和偏置调整结果,帮助稳定训练并改善收敛。在 GPT-2 的每个 Transformer 层中,它分别出现在自注意力之前和 MLP 之前。
随机失活(Dropout)
Dropout 是一种减少过拟合的正则化方法:训练时随机将部分激活值置零,减少模型对特定神经元的依赖,帮助它学习更能泛化的特征。模型推理时会关闭 Dropout。
残差连接(Residual Connections)
残差连接在 2015 年提出的 ResNet 中得到广泛应用。它提供一条绕过某些计算层的捷径,将输入加到这些层的输出上,缓解深层网络中的梯度传播困难。GPT-2 的每个 Transformer 层有两次残差连接,分别围绕注意力子层和 MLP 子层。
交互功能
你可以通过以下交互探索 Transformer 的内部工作过程:
- 输入自己的文字,观察模型如何处理输入并预测下一个词元,查看注意力权重、中间计算和最终输出概率。
- 调节温度滑块,观察概率分布怎样变化,以及如何影响生成的确定性与多样性。
- 切换 Top-k 和 Top-p 采样,尝试不同参数,观察候选范围和概率分布如何变化。
- 探索注意力图,将指针移到词元上,高亮显示相关权重,查看模型如何利用上下文。
视频教程(英文)
Transformer Explainer 是如何实现的?
本工具在浏览器中运行 GPT-2(small)。模型基于 Andrej Karpathy 的 nanoGPT 项目中的 PyTorch 实现,并转换为 ONNX 格式,通过 ONNX Runtime 在浏览器中执行。界面使用 JavaScript 和 Svelte,动态可视化使用 D3.js。数值会随用户输入更新。
谁开发了 Transformer Explainer?
Transformer Explainer 由佐治亚理工学院的 Aeree Cho、Grace C. Kim、Alexander Karpekov、Alec Helbling、Jay Wang、Seongmin Lee、Benjamin Hoover、Polo Chau 共同开发。